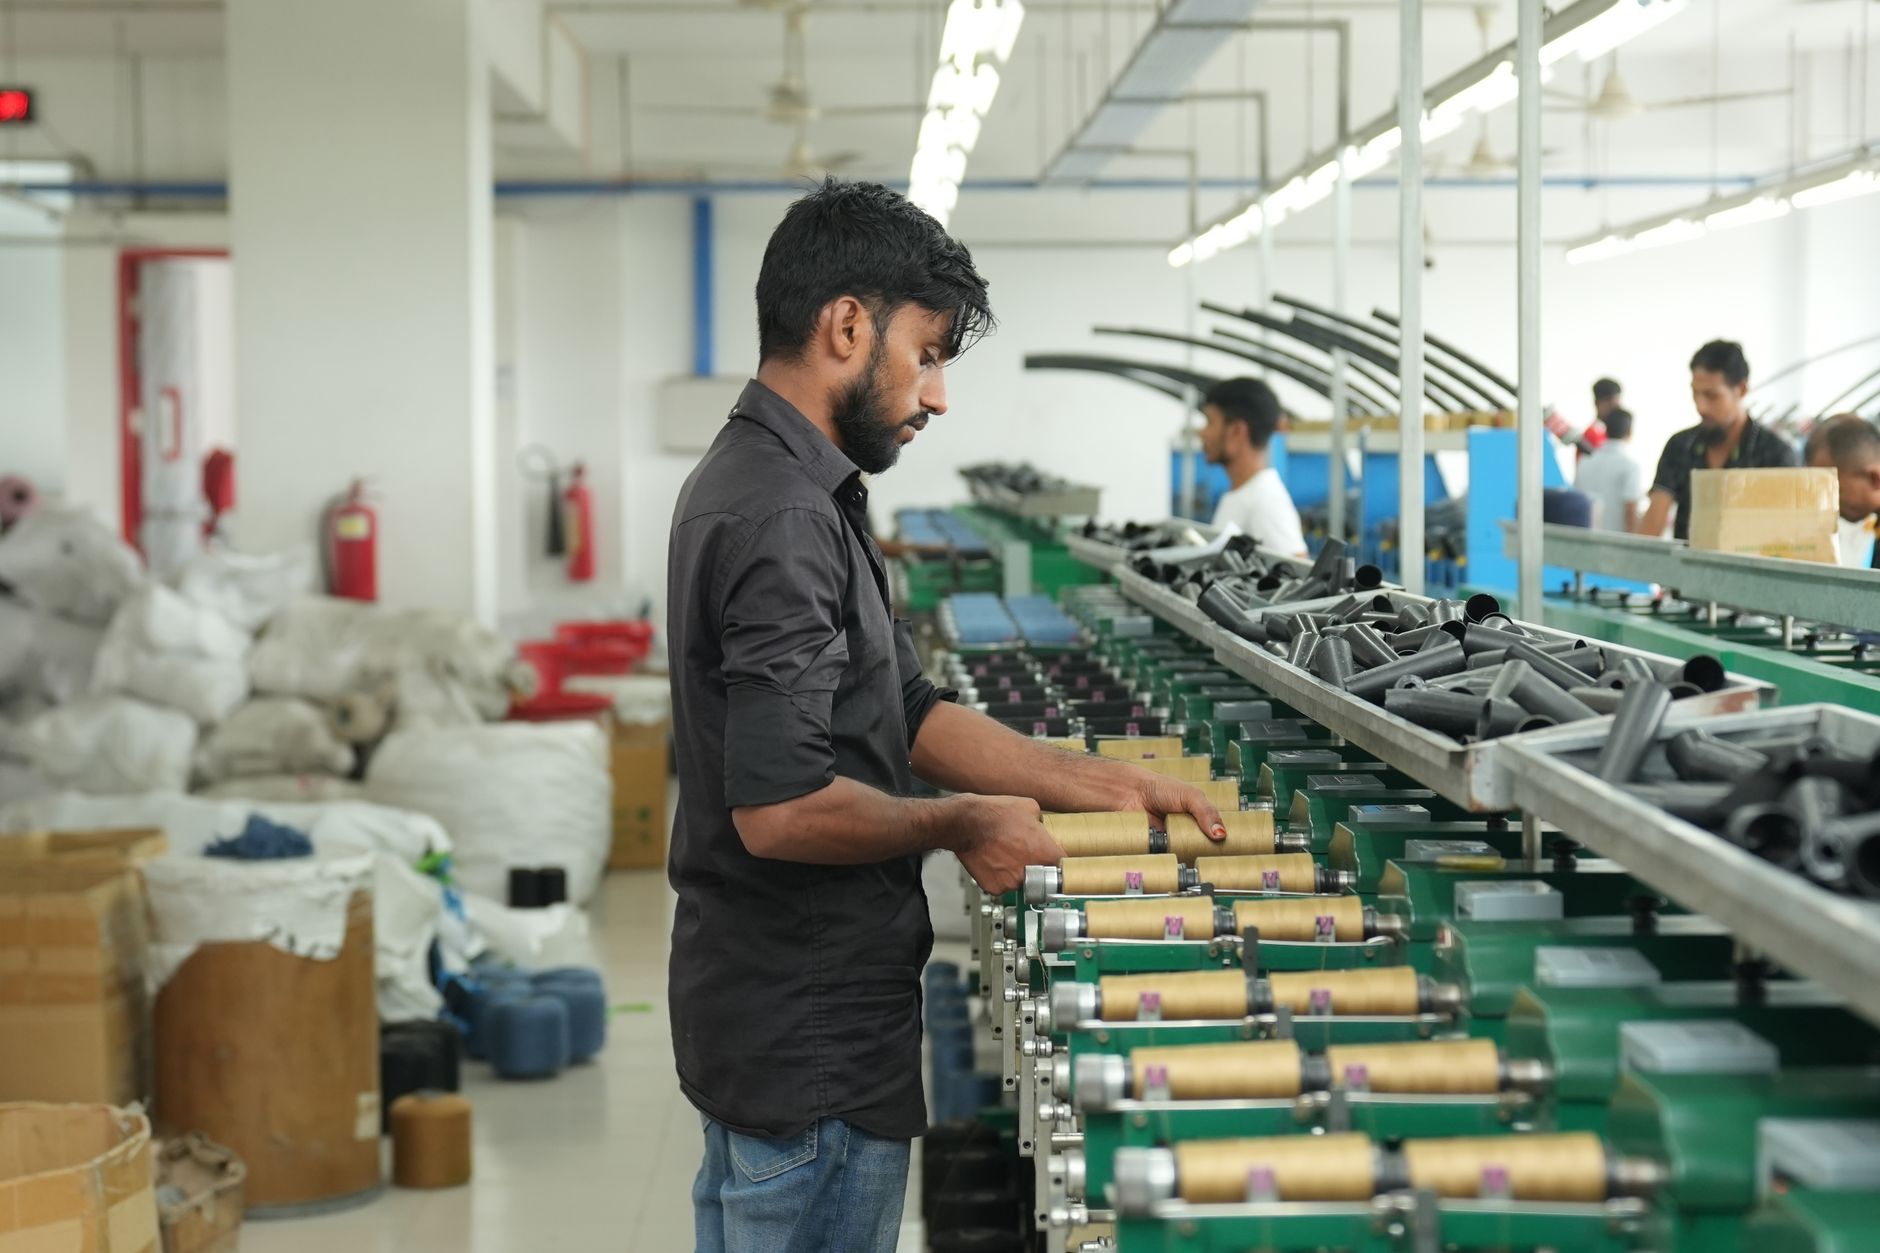
製造現場では、機械学習を活用したデータ分析と、生成AIによる作業支援の両輪で生産性と品質の向上が期待されています。ただし安全規程・設計図・取引先情報といった企業機密や知財の取り扱いに配慮した運用設計が不可欠です。本記事では、現場の背景・課題を踏まえ、具体的な活用領域・導入ステップ・リスク対策を、製造業固有の語彙で整理します。
背景と課題
- 品質不良の原因究明と歩留まり改善が喫緊の課題。検査データの多様性とラベル付けの揺らぎが、AIモデルの信頼性を左右します。
- 設備のダウンタイムを削減する予知保全は重要ですが、センサ種別が多くデータ頻度も異なるため、データ基盤の整備が前提になります。
- 生産計画は需要変動・部材不足・ラインのバランス崩れで頻繁に変動します。AI活用にはリアルタイム性と安定性が求められます。
- データのサイロ化と品質不足は、現場の意思決定を遅延させます。図面・部品情報・取引先情報のアクセス権限管理も重要です。
- デジタル人材不足とAIリテラシー差は、導入初期の大きな障壁になります。
製造業における生成AIの活用領域
- 品質管理と検査の自動化
- 予知保全と設備運用の最適化
- 生産計画・ライン最適化と需要予測
- データ基盤・ガバナンスとセキュリティ
- 現場作業支援と作業指示の自動化
- 調達・サプライチェーン安定化
導入にあたっては、データの取得元・取得頻度・リアルタイム性といったデータ設計を先に整えることが肝要です。例えば、品質データはラベル付けの統一基準を設け、設備データは時系列で整列させ、図面情報は最新バージョン管理とアクセス制御を徹底します。現場では、AIが提案する修正案を人が最終判断するハイブリッド運用を基本とし、誤検知のコストと手戻りを最小化します。参考として、機械学習の活用事例全体の理解には以下の総説も有用です。 https://www.ibm.com/jp-ja/think/topics/machine-learning-use-cases
品質管理では、検査画像の欠陥検出や寸法の自動読み取り、設備データの異常検知を組み合わせることで歩留まり改善が期待できます。予知保全は、振動・温度・電流といったセンサデータを統合し、ダウンタイムを先読みしてスケジューリングを改善します。生産計画では、変更発生時のロット追跡とラインバランスの再構成をAIが支援します。データ基盤とガバナンスは、データの出所・品質・アクセス権を透明化する設計を求められ、現場の活用を安定させます。現場作業では、作業指示を生成AIが要点だけ抜き出して提示し、作業員の理解を支援します。取引先情報の取り扱いには、機密データのマスク・最小権限原則・監査ログの確保が欠かせません。
参考として、機械学習の仕組みや基礎から実装イメージまでを解説した資料も活用できます。 https://jp.mathworks.com/discovery/machine-learning.html
また、製造データ活用の解説としてデータ活用例を紹介している資料も併読すると実務感が高まります。 https://jpn.nec.com/solution/dotdata/tips/machine-learning/index.html
データガバナンスの観点からは、データ取得元の明確化・データ品質指標の設定・セキュリティポリシーの適用が導入初期の要となります。導入の検討と合わせて、PoCでの検証計画を立て、ROIとKPIを設定することを推奨します。
導入ステップとROIの評価
- PoC(概念実証): 限定的なデータセットと現場のペルソナを設定して、効果指標を定義します。データ品質とラベル付けの整備状況を確認します。
- 本導入: PoCで得られたモデルを実機ラインに適用。安全規程・図面・取引先情報の取扱いルールを厳格化し、権限管理を適用します。
- 運用・改善: 運用後のKPIを継続監視。検知精度・アラームの信頼性・ライン稼働率・不良率の変化を評価します。
導入のROIは、ダウンタイム削減・不良率低下・ラインの再バランスによる生産能力の向上と、データ品質の改善による長期の改善サイクルの短縮を総合的に評価します。実務的には、投資対効果を算出する際に「初期費用+運用費用」に対して「年間の稼働率向上+不良削減効果」を指標化します。
ツール比較と導入フェーズ
読み方: この表は、現場で検討するAIツールの性質と導入時の留意点を横並びで示したものです。列B以降に、ツールの適用領域と注意点を整理しています。
| 列A | 列B | 列C | 列D |
|---|---|---|---|
| ツール名 | 主な用途 | 導入形態 | 主な注意点 |
| ChatGPT(OpenAI) | 文書要約・作業指示作成・FAQ作成 | クラウド/ローコード連携 | データソースの機密性を守る運用設計が必須 |
| Claude 2(Anthropic) | 会話型支援・意思決定支援 | クラウド/API連携 | 商用利用時の規約確認と監査ログ |
| Bard(Google) | ダッシュボード作成・質問応答 | クラウド | データ保護と社内ポリシー適用の整合性 |
| Stable Diffusion | 図面の補助イメージ生成・ビジュアル化 | オンライン/オフライン | 画像生成の責任範囲と著作権・適用範囲の検討 |
読み方: 導入フェーズ表は、PoCから運用までの各段階での目的と活動を整理したものです。
| 列A | 列B | 列C | 列D |
|---|---|---|---|
| フェーズ | 目的 | 主な活動 | 指標/アウトプット |
| PoC | 実現可能性の確認 | データ取得・前処理・初期モデル検証 | 検証結果・初期精度・データ品質評価 |
| 本導入 | 実運用準備 | データ連携・セキュリティ設定・現場教育 | 稼働率・アラーム信頼度 |
| 運用 | 改善と定着 | モデル更新・監視・ルール整備 | KPI達成率・不良率変動・教育完遂率 |
| 拡張 | スケールアップ | 他ライン・他部門への展開 | ROI継続性・適用領域拡張度 |
導入時のリスクと対策
- データセキュリティと法令遵守の確保。機密情報のアクセス権限を最小化し、監査ログを残します。
- 品質データのラベリング精度の確保。人手による検証と、ラベル付け品質の定量的評価を併用します。
- 組織変革と人材育成。現場教育とチェンジマネジメントの計画を事前に組み込みます。
- 導入コストとROIの透明性。初期費用とランニングコスト、効果指標を明確化します。
成功ポイントと展開のヒント
- 現場の声を反映するPoC設計。現場の実データと作業ワークフローを組み合わせ、導入初期の混乱を抑えます。
- データ品質を最優先。品質データの整備とラベル付け指針を社内で統一します。
- ハイブリッド運用を推奨。AIの提案を人が最終判断する体制で、誤検知のコストを抑えます。
- 安全規程・図面・取引先情報の取り扱いを徹底。アクセス制御・監査・データマスキングを設計に組み込みます。
- 導入後も継続的な改善。ラインや部門間での横展開と、KPIの見直しを続けます。
参考として、機械学習の基本と活用事例を解説する資料を併読すると実務理解が深まります。 https://jp.mathworks.com/discovery/machine-learning.html
外部リファレンスとして、製造データ活用の解説がまとまった資料も有用です。 https://www.ibm.com/jp-ja/think/topics/machine-learning-use-cases
さらに、製造データ活用を具体的に解説する資料として、データ活用の実務ガイドが役立ちます。 https://jpn.nec.com/solution/dotdata/tips/machine-learning/index.html
参考・外部リンク
- https://www.ibm.com/jp-ja/think/topics/machine-learning-use-cases
- https://www.matrixflow.net/case-study/49/
- https://jp.mathworks.com/discovery/machine-learning.html
- https://jpn.nec.com/solution/dotdata/tips/machine-learning/index.html
編集ポリシーについて
本記事は、生成 AI の業務活用に関する一般的な参考情報として編集しています。特定企業・製品の効果を保証するものではなく、導入判断は各組織のポリシー・セキュリティ要件に沿って行ってください。
編集方針として、公的機関・ベンダー公式・信頼できる一次情報を優先し、モデル名・料金・機能は変更されうる旨を明記しています。掲載内容は一般的な事例の整理であり、個別の契約・法務・情報セキュリティの最終判断の代行ではありません。